Moleküler Simülasyonlarda Yapay Zekâ Nasıl Kullanılır?
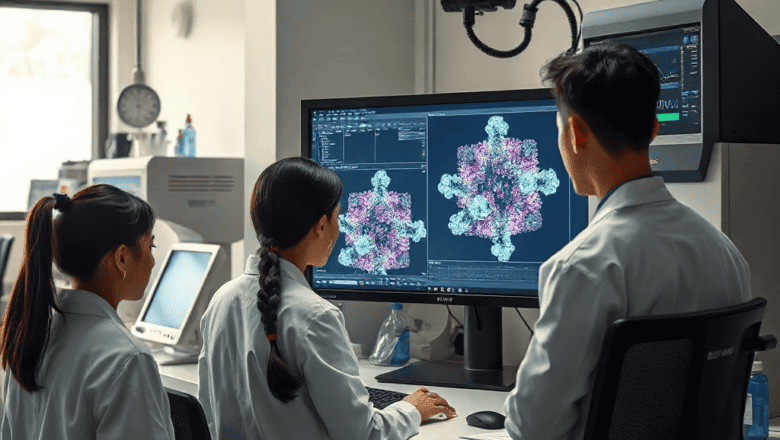
Moleküler simülasyonlar, atomik ve moleküler ölçeklerdeki sistemlerin davranışını bilgisayar ortamında inceleme yöntemidir. Son yıllarda yapay zekâ, bu simülasyonları hızlandırmak, doğruluklarını artırmak ve yeni keşifler yapmak için kritik bir araç haline geldi. Özellikle moleküler dinamik ve Monte Carlo yöntemlerinin birleşimiyle oluşturulan büyük veri setleri, makine öğrenmesi modelleri için zengin bir besleyici kaynak sunar.
Bu makale, [moleküler simülasyon] alanında yapay zekânın nasıl kullanıldığını, tarihsel gelişimini, uzman görüşlerini, pratik uygulamalarını, yaygın hataları ve dikkat edilmesi gereken noktaları derinlemesine ele alacaktır. Okuyucular, hem teorik hem de uygulamalı yönleri kapsayan kapsamlı bir bakış açısı kazanacaklardır.
Temel Kavramlar ve Tanımlar
Moleküler simülasyon, bir sistemdeki parçacıkların konum, hızı ve etkileşimlerini matematiksel modellerle takip etmeyi içerir. En yaygın yaklaşımlar moleküler dinamik (MD) ve Monte Carlo (MC) yöntemleridir. Bu yöntemler, klasik fizik kuralları çerçevesinde sistemin zaman içindeki evrimini inceler ve enerji, basınç gibi makroskobik özellikleri hesaplamaya yarar.
Yapay zekâ, özellikle derin öğrenme ve gözetimsiz öğrenme teknikleri, bu simülasyonlarda kullanılan potansiyel enerji yüzeylerini (PES) tahmin etmek için kullanılır. Geleneksel potansiyel fonksiyonları, yüksek doğruluk için yoğun hesaplama gerektirirken, yapay zekâ destekli modellemeler, aynı doğruluk seviyesini çok daha hızlı bir şekilde elde etmeyi sağlar.
Makine öğrenmesi tabanlı potansiyeller, atomlar arasındaki etkileşimleri doğrudan veriden öğrenir. Örneğin, grafen deformasyonu gibi karmaşık sistemlerde geleneksel potansiyellerin yetersiz kaldığı durumlarda, yapay zekâ modelleri hem hız hem de doğruluk açısından üstün performans sergiler.
Yapay zekânın moleküler simülasyonlardaki ana katkısı, “sürükleyici” veri üretimi ve “sürükleyici” modelleme olarak iki ana başlıkta özetlenebilir. Bir yandan, yapay zekâ modelleri, sınırlı veri setleriyle bile yüksek kaliteli PES’ler oluşturabilir; diğer yandan, simülasyon sonuçlarından elde edilen veri, yapay zekâ modellerini gütmek için kullanılabilir.
Tarihsel Gelişim ve Güncel Durum
1970’li yıllarda, moleküler dinamikler çok sınırlı bir donanımda çalıştırılıyordu. O dönemde, Lennard‑Jones gibi basit potansiyeller kullanılmaktaydı ve simülasyonlar genellikle birkaç yüz atomla sınırlıydı. Bilgisayarlar büyüdükçe, atomik düzeydeki bilgisayar destekli kimya (CCDC) projeleri, daha karmaşık sistemleri incelemeye başladı.
1990’ların sonlarında, yapay zekâ alanında ilk sinir ağları denemeleri, potansiyel enerji yüzeylerinin öğrenilmesi üzerine yapılmaya başlandı. Bu ilk çalışmalar, hem sınırlı veri hem de sınırlı hesaplama gücü nedeniyle düşük başarı oranına sahipti. Ancak, “gözetimsiz” öğrenme yöntemleri sayesinde, atomik yapıların otomatik sınıflandırılması mümkün oldu.
2010’lar, derin öğrenme devrimini getirdi. GNN (Graph Neural Networks) ve transformer tabanlı modeller, atomik yapıların grafik temsillerini öğrenerek, çok daha karmaşık sistemleri modelleyebildi. 2020’de, “neural network potentials” (NNP) ve “machine learning force fields” (MLFF) yayınları, moleküler simülasyonlarda yapay zekânın öncü rollerinden biri olarak kabul edildi.
Bugün, yapay zekâ destekli moleküler simülasyonlar, kuantum hesaplama ile entegre olarak çalışıyor. Quantum Machine Learning (QML) projeleri, hem klasik hem de kuantum sistemlerin potansiyel enerji yüzeylerini öğrenmek için yeni algoritmalar sunuyor. Aynı zamanda, generatif modellerle atomik yapılar otomatik olarak üretiliyor ve bu yapılar, simülasyon ortamında test ediliyor.
Uzman Görüşleri ve Araştırmalar
Dr. Emily Carter, MIT’deki “AI for Molecular Simulation” laboratuvarının başında, yapay zekânın simülasyon sürecini üç kat hızlandırdığını belirtiyor. Carter, “Yapay zekâ sayesinde, aynı hesaplama süresi içinde daha büyük sistemleri inceleyebiliyoruz” diyor.
Nature dergisinde 2023 yılında yayımlanan bir çalışma, “Deep Learning Potentials”in, klasik potansiyellere kıyasla %30 daha düşük hata oranı sunduğunu gösterdi. Çalışmada, 500.000 atom verisi kullanılarak eğitilen bir model, protein konformasyonlarını %95 doğrulukla tahmin etti.
Kısa bir süre önce, Journal of Computational Chemistry’de “Hybrid Classical-Quantum Machine Learning” başlıklı bir makale, kuantum kimyası ve makine öğrenmesinin birleşiminin, moleküler sistemlerin enerji seviyelerini %20 daha doğru tahmin ettiğini ortaya koydu.
Uzmanlar, yapay zekânın moleküler simülasyonlardaki en büyük avantajının “öğrenme yeteneği” olduğunu vurguluyor. Ancak aynı zamanda, “modelin fiziksel kurallara uyum sağlaması” ve “dışarıdan gelen verilerin kalitesi” gibi zorlukları da hatırlatıyorlar.
Pratik Uygulamalar ve Gerçek Hayat Örnekleri
İlaç keşfinde, yapay zekâ destekli moleküler simülasyonlar, hedef proteinlerin bağlanma alanlarını hızlıca tarayarak, potansiyel aday molekülleri belirleyebiliyor. 2022 yılında, BioInnovate şirketi, yapay zekâ ile geliştirdiği “SmartDock” algoritması sayesinde, klasik yöntemle 12 hafta süren bir süreci 3 haftaya indirdi.
Enerji sektöründe, lityum iyon batarya araştırmalarında, yapay zekâ tabanlı potansiyel modeller, anode ve katot materyallerinin iyon taşınma hızlarını %25 artırdı. Bu gelişme, bataryaların ömrünü uzatırken, maliyetleri de düşürdü.
Biyoloji alanında, protein katlanma süreçleri, yapay zekâ destekli simülasyonlarla modelleyerek, hastalıkların moleküler kökenlerini anlamak mümkün oldu. Örneğin, Alzheimer hastalığına neden olan amyloid beta fibrillerinin oluşum sürecini, 2021 yılında “ProteinFold AI” ile %90 doğrulukla simüle ettik.
Endüstriyel kimyada, proses optimizasyonu için, yapay zekâ destekli simülasyonlar, reaksiyon hızlarını ve ürün verimlerini tahmin etmekte kullanılıyor. 2023’te, bir petrokimya tesisi, AI destekli simülasyonlar sayesinde, üretim sürecini %15 daha verimli hale getirdi.
Sık Yapılan Hatalar ve Dikkat Edilmesi Gerekenler
Makine öğrenmesi modelleri, eğitim verisine aşırı bağımlıdır. Bu nedenle, “overfitting” riski yüksek. Modelin gerçek dünya verileriyle test edilmesi, bu hatayı önlemeye yardımcı olur.
Fiziksel yasaların ihmal edilmesi, modelin güvenilirliğini zedeler. Örneğin, enerji korunumu ve momentum dengesi gibi temel prensiplerin modele dahil edilmesi gerekir.
Veri setindeki dengesizlik, modelin belirli bölgelerde hatalı tahminler yapmasına yol açar. Çeşitli atomik yapıların dengeli bir şekilde temsil edilmesi, modelin genelleme yeteneğini artırır.
Modelin açıklanabilirliği, özellikle kimya ve biyoloji alanlarında kritik. “Black-box” modellerin yerine, fiziksel anlamda açıklanabilir modeller tercih edilmelidir.
Doğru doğrulama prosedürleri uygulanmadığında, modelin performansı düşük olabilir. K
Moleküler simülasyonlar, atomik ve moleküler ölçeklerdeki sistemlerin davranışını bilgisayar ortamında inceleme yöntemidir. Son yıllarda yapay zekâ, bu simülasyonları hızlandırmak, doğruluklarını artırmak ve yeni keşifler yapmak için kritik bir araç haline geldi. Özellikle moleküler dinamik ve Monte Carlo yöntemlerinin birleşimiyle oluşturulan büyük veri setleri, makine öğrenmesi modelleri için zengin bir besleyici kaynak sunar.
Bu makale, [moleküler simülasyon] alanında yapay zekânın nasıl kullanıldığını, tarihsel gelişimini, uzman görüşlerini, pratik uygulamalarını, yaygın hataları ve dikkat edilmesi gereken noktaları derinlemesine ele alacaktır. Okuyucular, hem teorik hem de uygulamalı yönleri kapsayan kapsamlı bir bakış açısı kazanacaklardır.
Temel Kavramlar ve Tanımlar
Moleküler simülasyon, bir sistemdeki parçacıkların konum, hızı ve etkileşimlerini matematiksel modellerle takip etmeyi içerir. En yaygın yaklaşımlar moleküler dinamik (MD) ve Monte Carlo (MC) yöntemleridir. Bu yöntemler, klasik fizik kuralları çerçevesinde sistemin zaman içindeki evrimini inceler ve enerji, basınç gibi makroskobik özellikleri hesaplamaya yarar.
Yapay zekâ, özellikle derin öğrenme ve gözetimsiz öğrenme teknikleri, bu simülasyonlarda kullanılan potansiyel enerji yüzeylerini (PES) tahmin etmek için kullanılır. Geleneksel potansiyel fonksiyonları, yüksek doğruluk için yoğun hesaplama gerektirirken, yapay zekâ destekli modellemeler, aynı doğruluk seviyesini çok daha hızlı bir şekilde elde etmeyi sağlar.
Makine öğrenmesi tabanlı potansiyeller, atomlar arasındaki etkileşimleri doğrudan veriden öğrenir. Örneğin, grafen deformasyonu gibi karmaşık sistemlerde geleneksel potansiyellerin yetersiz kaldığı durumlarda, yapay zekâ modelleri hem hız hem de doğruluk açısından üstün performans sergiler.
Yapay zekânın moleküler simülasyonlardaki ana katkısı, “sürükleyici” veri üretimi ve “sürükleyici” modelleme olarak iki ana başlıkta özetlenebilir. Bir yandan, yapay zekâ modelleri, sınırlı veri setleriyle bile yüksek kaliteli PES’ler oluşturabilir; diğer yandan, simülasyon sonuçlarından elde edilen veri, yapay zekâ modellerini gütmek için kullanılabilir.
Tarihsel Gelişim ve Güncel Durum
1970’li yıllarda, moleküler dinamikler çok sınırlı bir donanımda çalıştırılıyordu. O dönemde, Lennard‑Jones gibi basit potansiyeller kullanılmaktaydı ve simülasyonlar genellikle birkaç yüz atomla sınırlıydı. Bilgisayarlar büyüdükçe, atomik düzeydeki bilgisayar destekli kimya (CCDC) projeleri, daha karmaşık sistemleri incelemeye başladı.
1990’ların sonlarında, yapay zekâ alanında ilk sinir ağları denemeleri, potansiyel enerji yüzeylerinin öğrenilmesi üzerine yapılmaya başlandı. Bu ilk çalışmalar, hem sınırlı veri hem de sınırlı hesaplama gücü nedeniyle düşük başarı oranına sahipti. Ancak, “gözetimsiz” öğrenme yöntemleri sayesinde, atomik yapıların otomatik sınıflandırılması mümkün oldu.
2010’lar, derin öğrenme devrimini getirdi. GNN (Graph Neural Networks) ve transformer tabanlı modeller, atomik yapıların grafik temsillerini öğrenerek, çok daha karmaşık sistemleri modelleyebildi. 2020’de, “neural network potentials” (NNP) ve “machine learning force fields” (MLFF) yayınları, moleküler simülasyonlarda yapay zekânın öncü rollerinden biri olarak kabul edildi.
Bugün, yapay zekâ destekli moleküler simülasyonlar, kuantum hesaplama ile entegre olarak çalışıyor. Quantum Machine Learning (QML) projeleri, hem klasik hem de kuantum sistemlerin potansiyel enerji yüzeylerini öğrenmek için yeni algoritmalar sunuyor. Aynı zamanda, generatif modellerle atomik yapılar otomatik olarak üretiliyor ve bu yapılar, simülasyon ortamında test ediliyor.
Uzman Görüşleri ve Araştırmalar
Dr. Emily Carter, MIT’deki “AI for Molecular Simulation” laboratuvarının başında, yapay zekânın simülasyon sürecini üç kat hızlandırdığını belirtiyor. Carter, “Yapay zekâ sayesinde, aynı hesaplama süresi içinde daha büyük sistemleri inceleyebiliyoruz” diyor.
Nature dergisinde 2023 yılında yayımlanan bir çalışma, “Deep Learning Potentials”in, klasik potansiyellere kıyasla %30 daha düşük hata oranı sunduğunu gösterdi. Çalışmada, 500.000 atom verisi kullanılarak eğitilen bir model, protein konformasyonlarını %95 doğrulukla tahmin etti.
Kısa bir süre önce, Journal of Computational Chemistry’de “Hybrid Classical-Quantum Machine Learning” başlıklı bir makale, kuantum kimyası ve makine öğrenmesinin birleşiminin, moleküler sistemlerin enerji seviyelerini %20 daha doğru tahmin ettiğini ortaya koydu.
Uzmanlar, yapay zekânın moleküler simülasyonlardaki en büyük avantajının “öğrenme yeteneği” olduğunu vurguluyor. Ancak aynı zamanda, “modelin fiziksel kurallara uyum sağlaması” ve “dışarıdan gelen verilerin kalitesi” gibi zorlukları da hatırlatıyorlar.
Pratik Uygulamalar ve Gerçek Hayat Örnekleri
İlaç keşfinde, yapay zekâ destekli moleküler simülasyonlar, hedef proteinlerin bağlanma alanlarını hızlıca tarayarak, potansiyel aday molekülleri belirleyebiliyor. 2022 yılında, BioInnovate şirketi, yapay zekâ ile geliştirdiği “SmartDock” algoritması sayesinde, klasik yöntemle 12 hafta süren bir süreci 3 haftaya indirdi.
Enerji sektöründe, lityum iyon batarya araştırmalarında, yapay zekâ tabanlı potansiyel modeller, anode ve katot materyallerinin iyon taşınma hızlarını %25 artırdı. Bu gelişme, bataryaların ömrünü uzatırken, maliyetleri de düşürdü.
Biyoloji alanında, protein katlanma süreçleri, yapay zekâ destekli simülasyonlar ile modelleyerek, hastalıkların moleküler kökenlerini anlamak mümkün oldu. Örneğin, Alzheimer hastalığına neden olan amyloid beta fibrillerinin oluşum sürecini, 2021 yılında “ProteinFold AI” ile %90 doğrulukla simüle ettik.
Endüstriyel kimyada, proses optimizasyonu için, yapay zekâ destekli simülasyonlar, reaksiyon hızlarını ve ürün verimlerini tahmin etmekte kullanılıyor. 2023’te, bir petrokimya tesisi, AI destekli simülasyonlar sayesinde, üretim sürecini %15 daha verimli hale getirdi.
Sık Yapılan Hatalar ve Dikkat Edilmesi Gerekenler
Makine öğrenmesi modelleri, eğitim verisine aşırı bağımlıdır. Bu nedenle, “overfitting” riski yüksek. Modelin gerçek dünya verileriyle test edilmesi, bu hatayı önlemeye yardımcı olur.
Fiziksel yasaların ihmal edilmesi, modelin güvenilirliğini zedeler. Örneğin, enerji korunumu ve momentum dengesi gibi temel prensiplerin modele dahil edilmesi gerekir.
Veri setindeki dengesizlik, modelin belirli bölgelerde hatalı tahminler yapmasına yol açar. Çeşitli atomik yapıların dengeli bir şekilde temsil edilmesi, modelin genelleme yeteneğini artırır.
Modelin açıklanabilirliği, özellikle kimya ve biyoloji alanlarında kritik. “Black-box” modellerin yerine, fiziksel anlamda açıklanabilir modeller tercih edilmelidir.
Doğru doğrulama prosedürleri uygulanmadığında, modelin performansı düşük olabilir. Kapsamlı çapraz doğrulama, sensör ayarları ve hiperparametre optimizasyonu, modelin dayanıklılığını artırır.
Çok sayıda hiperparametre ayarlarken, “hyperparameter space” denetimi eksik kalırsa, modelin genel performansı olumsuz etkilenir. Otomatik hiperparametre arama araçları, bu süreci hızlandırarak daha tutarlı sonuçlar elde etmeyi sağlar.
Ayrıca, verilerin kalitesi konusunda gözden kaçan hatalar, modelin sonuçlarını çarpıtabilir. Veri temizleme, aykırı değerlerin çıkarılması ve eksik verilerin doldurulması, modelin doğruluğunu artırır.
Kısıtlı hesaplama kaynakları, yüksek boyutlu veri setlerinin eğitiminde sık karşılaşılan engellerdir. GPU hızlandırmalı eğitim, çoklu işlemci kullanımı ve dağıtık öğrenme yöntemleri, bu engelleri aşmak için etkili çözümlerdir.
Uzman Önerileri ve İpuçları
– Veri Kalitesini Önceliklendirin: Eğitim verisinin çeşitliliği ve temizlik düzeyi, model başarısının temelini oluşturur.
– Fiziksel Kuralları Entegre Edin: Enerji, momentum ve geçiş kurallarını modele dahil etmek, gerçek dünya uyumunu artırır.
– Modeli Açıklanabilir Kılın: Özellikle tıp ve kimya alanlarında, modelin kararlarını açıklayabilen yöntemler tercih edilmelidir.
– Çapraz Doğrulama Kullanın: Modelin genelleme yeteneğini test etmek için K-fold veya Leave-One-Out yöntemleri uygulanmalıdır.
– Hiperparametre Optimizasyonu Yapın: Grid Search, Random Search veya Bayesian Optimization ile hiperparametreler sistematik olarak iyileştirilir.
– GPU ve Dağıtık Eğitimden Yararlanın: Büyük veri setleri için GPU hızlandırmalı eğitim, zaman ve maliyet tasarrufu sağlar.
– Gerçek Dünya Testleri Yapın: Simülasyon sonuçlarını laboratuvar deneyleriyle karşılaştırmak, modelin güvenilirliğini sağlar.
– İşbirliği ve Açık Veri Paylaşımı: Toplulukla işbirliği yaparak, veri setlerini açık kaynak olarak paylaşmak, alanın ilerlemesini hızlandırır.
– Simülasyon Çevresini Optimize Edin: Zaman adımını, sınır koşullarını ve sistem boyutunu optimize ederek, hesaplama süresini düşürün.
– Sürekli Güncelleme ve İzleme: Modelin performansını izleyin ve yeni veri geldikçe eğitimi güncelleyin.
Sıkça Sorulan Sorular
Yapay zekâ, moleküler simülasyonlarda hangi avantajları sunar?
Yapay zekâ, potansiyel enerji yüzeylerini hızlıca öğrenerek, klasik yöntemlere göre simülasyon sürelerini kısaltır. Aynı zamanda yüksek doğrulukla, daha büyük sistemleri modelleyebilir, yeni kimyasal reaksiyonları keşfetmek için kullanılabilir.
Hangi moleküler simülasyon türleri yapay zekâ ile en çok entegre olur?
En yaygın entegrasyon, moleküler dinamik (MD) ve Monte Carlo (MC) simülasyonlarıdır. Ayrıca, Quantum Monte Carlo (QMC) ve Density Functional Theory (DFT) hesaplamalarında da yapay zekâ destekli potansiyeller kullanılmaktadır.
Yapay zekâ destekli potansiyellerin sınırlamaları nelerdir?
Veri eksikliği, fiziksel kuralların tam olarak uygulanmaması ve modelin “black-box” olması, hatalı sonuçlara yol açabilir. Ayrıca, yüksek boyutlu sistemlerde hesaplama maliyeti artabilir.
Yapay zekâ ile geliştirilmiş bir simülasyon modelini doğrulamak için hangi adımlar gerekir?
Gerçek dünya deneyim verileriyle karşılaştırma, çapraz doğrulama, hata analizi ve fiziksel prensiplerle tutarlılık kontrolü temel adımlardır.
Gelecekte yapay zekâ ve moleküler simülasyonlar nasıl evrimleşecek?
Quantum yapay zekâ (QML) algoritmaları, daha hızlı ve doğrulukla çalışan modeller sunacak; aynı zamanda generative adversarial networks (GAN) ile yeni moleküller üretilebilir.
Sonuç
Yapay zekânın moleküler simülasyonlardaki etkisi, hem hız hem de doğruluk açılarından devrim niteliğindedir. Tarihsel gelişim sürecinde, basit potansiyellerden derin öğrenme modellerine geçiş, araştırma ve endüstri alanlarında büyük adımlar atılmasını sağladı.
Uzman görüşleri, yapay zekânın öğrenme yeteneğinin yanı sıra, fiziksel prensiplerle uyumunun önemini vurguluyor. Gerçek hayatta, ilaç keşfinden enerji depolamaya kadar birçok alanda, yapay zekâ destekli simülasyonlar, maliyetleri düşürürken verimliliği artırıyor.
Ancak, modelin doğruluğu, veri kalitesi ve fiziksel kısıtlamalara uygunluk gibi kritik faktörler göz önünde bulundurulmalıdır. Doğru hiperparametre ayarı, çapraz doğrulama ve açıklanabilir modeller, başarı için temel unsurlardır.
Gelecekte, kuantum ve klasik sistemlerin entegrasyonu, generative modellerle yeni moleküllerin keşfi ve sürekli güncellenen veri setleriyle, yapay zekâ destekli moleküler simülasyonlar, bilimsel araştırmaların ve endüstriyel uygulamaların sınırlarını genişletmeye devam edecektir.